GenAI soberana: asegurar el diagnóstico de DevOps
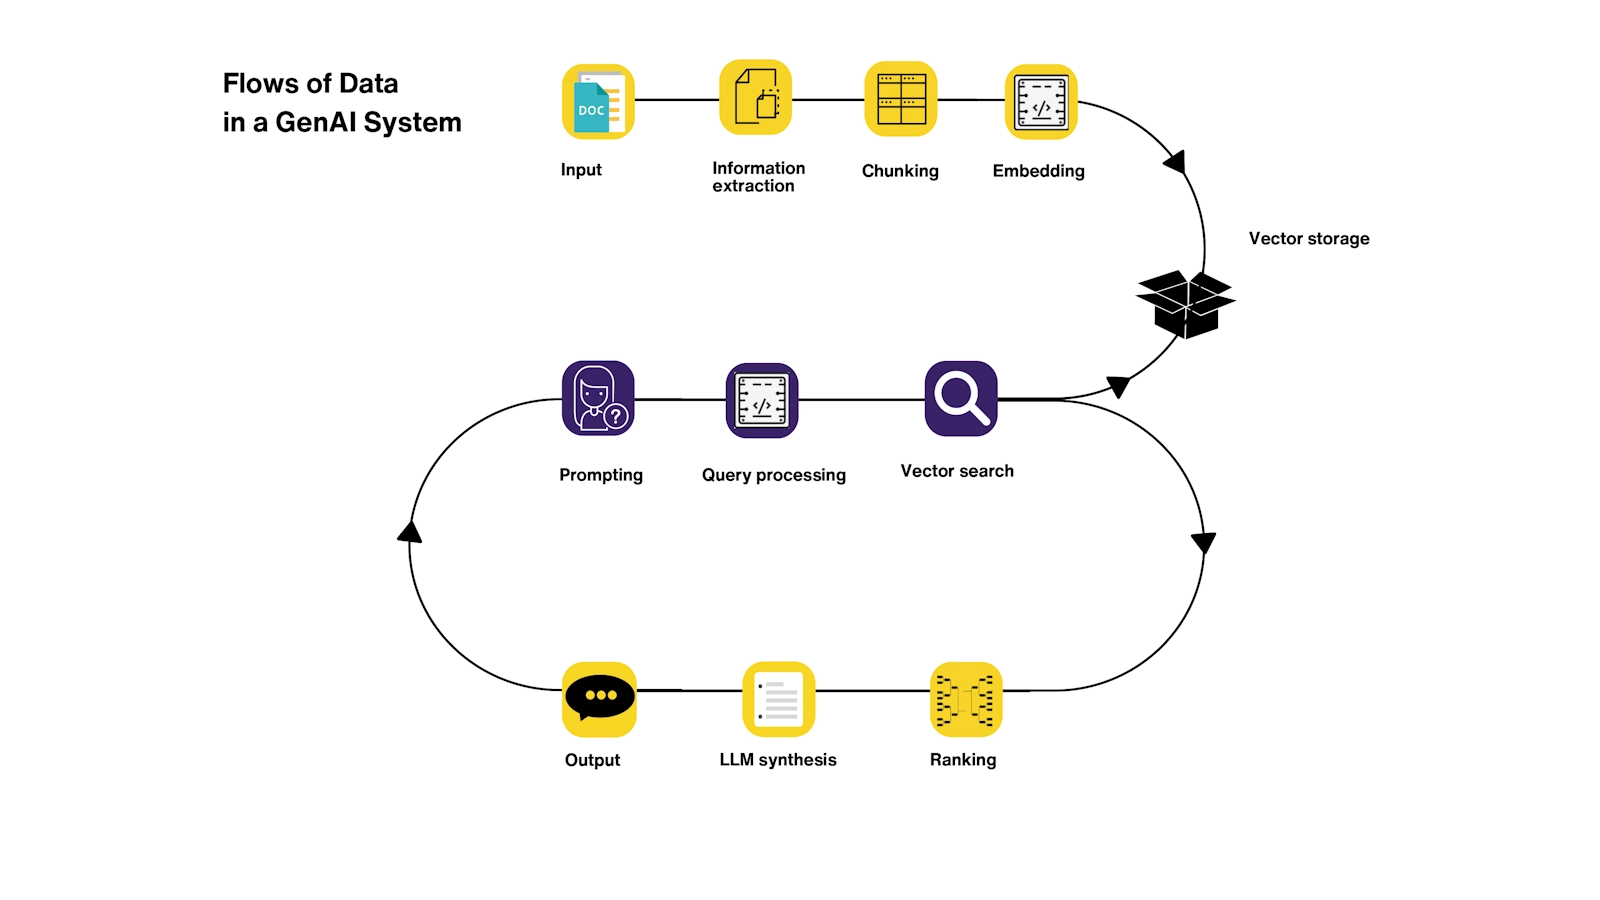
GenAI: convertir la observabilidad en diagnóstico operativo
Las plataformas de observabilidad pueden recopilar volúmenes considerables de datos. Permiten medir la latencia, seguir trazas distribuidas, recopilar registros, supervisar los pods de Kubernetes, analizar las conexiones TCP y mapear las dependencias entre los componentes.
Sin embargo, cuando se produce un incidente, el ingeniero no necesita consultar multitud de gráficos. Necesita una respuesta clara a una pregunta sencilla: ¿Por qué se ha ralentizado este servicio y qué debemos hacer ahora?
Aunque la pregunta sea sencilla, es imprescindible comprender el contexto:
- Qué ha ocurrido
- Cuándo ocurrió
- Qué usuarios o servicios se han visto afectados
- Cuál es la causa más probable
- Qué acciones son prioritarias
- Qué nivel de confianza se debe otorgar al diagnóstico
La IA generativa puede desempeñar un papel decisivo en esta transformación. Basándose en los datos recopilados y en el análisis causal, puede explicar un incidente en lenguaje natural, resumir su impacto y proponer los siguientes pasos.
Sin embargo, los datos de observabilidad son especialmente sensibles. Pueden revelar la topología de la red, los nombres de las aplicaciones críticas, las dependencias internas, los volúmenes de tráfico y las características de la infraestructura. Por lo tanto, su transmisión a un servicio externo puede plantear cuestiones de seguridad, cumplimiento normativo y soberanía. Una IA local o Edge permite dar respuesta a esta problemática. El modelo de lenguaje, los datos de observabilidad y el contexto de análisis pueden permanecer en el entorno de la empresa, al tiempo que se ofrece una interfaz conversacional a los equipos técnicos.
Un LLM no es un motor de causalidad
Es importante diferenciar dos funciones. El motor de observabilidad y análisis debe establecer los hechos:
- Las métricas observadas
- Los eventos
- Las dependencias
- Los cambios
- Las correlaciones
- Las hipótesis causales
A continuación, el modelo de lenguaje debe transformar estos resultados en lenguaje claro. Esta distinción limita el riesgo de obtener una respuesta plausible pero incorrecta. El LLM no debe inventar una causa a partir de un simple resumen. Debe basarse en los datos y las relaciones generadas por el motor analítico.
Por lo tanto, una arquitectura robusta puede seguir el siguiente esquema: Telemetría → Normalización y enriquecimiento → Correlación topológica → Detección de anomalías → Análisis causal → Contexto estructurado → LLM local → Diagnóstico en lenguaje natural.
El modelo generativo sirve entonces como interfaz de comprensión e interacción. No sustituye ni a los datos de observabilidad ni a los mecanismos que los analizan.
Proporcionar al modelo un contexto verificable con el RAG
Un enfoque RAG (Retrieval-Augmented Generation) consiste en seleccionar información útil en el momento de responder, en lugar de basarse únicamente en los conocimientos generales del modelo. El contexto puede incluir:
- El incidente en curso y los indicadores asociados
- Los recursos y servicios afectados
- Las relaciones topológicas pertinentes
- Los cambios recientes
- Los procedimientos internos
- Las recomendaciones aprobadas
El RAG puede ayudar a fundamentar la respuesta en información específica del entorno. Sin embargo, por sí solo no garantiza la exactitud del diagnóstico. La calidad depende, sobre todo, de la pertinencia de los datos recopilados, de su actualidad y de su coherencia.
Para facilitar la verificación, una respuesta debería distinguir claramente entre las observaciones (los datos constatados directamente), las hipótesis (las posibles explicaciones, acompañadas de sus elementos de apoyo), la información que falta (las comprobaciones necesarias para tomar una decisión) y las acciones propuestas (los próximos pasos, con sus posibles riesgos). Esta presentación ayuda al operador a evaluar la respuesta, en lugar de tratarla como una conclusión indiscutible.
Implementación local: controlar el ámbito de procesamiento
Los datos de observabilidad pueden revelar la topología de la red, las versiones de las aplicaciones críticas, las direcciones internas, las dependencias entre servicios, la información de los clientes, etc. Según las políticas de la organización, su transferencia a un servicio externo puede plantear cuestiones de seguridad, cumplimiento normativo y control de los datos.
Una implementación in situ o en el perímetro de la red (Edge) permite procesar localmente el modelo de lenguaje y el contexto utilizado para responder. De este modo, puede reducir la dependencia de un servicio externo para cada consulta y mantener el procesamiento en un entorno controlado por la empresa.
Sin embargo, con leyes como la FISA 702 de los Estados Unidos, el término "local" no basta para describir todo el alcance del control. También hay que tener en cuenta la recopilación, el transporte, el almacenamiento, la indexación, la gestión de accesos, el registro, las actualizaciones y las dependencias de componentes de terceros. Por lo tanto, la soberanía depende de la arquitectura y su gobernanza en su conjunto, no únicamente del lugar donde se ejecuta el modelo.
Más allá del aislamiento del tratamiento de datos sensibles, una infraestructura de GPU local puede utilizarse para:
- Servir el modelo de lenguaje
- Acelerar la generación de respuestas
- Analizar grandes volúmenes de contexto
- Mantener una baja latencia
- Reducir los costes corrientes
Integrar la IA generativa local en la cadena de observabilidad
Implementar un modelo local no consiste únicamente en instalar un LLM en un servidor equipado con GPU. Es necesario organizar los intercambios entre la plataforma de observabilidad, los componentes de análisis y el asistente, al tiempo que se determina a qué datos puede acceder este último y qué operaciones está autorizado a realizar.
Una arquitectura puede separar estas responsabilidades en varios componentes: la plataforma recopila y normaliza la telemetría, los motores de detección y correlación identifican las señales relevantes, una capa de búsqueda selecciona los datos útiles para la consulta, por último, el modelo local formula una respuesta a partir de ese contexto. Esta separación facilita la evolución de cada componente y evita que se le asignen al modelo tareas para las que no está diseñado, como establecer por sí solo una causalidad a partir de datos brutos.
También debe definirse el ámbito de actuación del asistente. Según las necesidades, puede consultar incidentes, métricas, cambios recientes o procedimientos internos. Los accesos pueden limitarse por rol, servicio o entorno, de modo que una respuesta no revele información a la que el usuario no tenga acceso en las herramientas operativas habituales. El registro y la gestión de las credenciales deben cumplir los mismos requisitos que para el resto de componentes de la plataforma.
La elección de una implementación local también influye en la explotación. El equipo debe prever la disponibilidad del servicio de inferencia, la gestión de las versiones del modelo, las actualizaciones, la supervisión del consumo de la GPU y los mecanismos de respaldo en caso de que el asistente deje de estar disponible. En caso de incidente, la asistencia no debería convertirse en un nuevo punto de fallo: las herramientas habituales de diagnóstico deben seguir estando accesibles.
Por último, la integración puede realizarse de forma progresiva. Se puede empezar con un asistente de solo lectura, que sintetice elementos verificables y proponga líneas de investigación. Una vez evaluada su calidad en incidentes representativos, puede integrarse en los procedimientos operativos y, posteriormente, autorizarse a que active determinadas acciones supervisadas. Las operaciones de gran impacto, como reiniciar un servicio, mover pods o modificar una configuración, pueden seguir estando sujetas a validación humana.
El modelo local se convierte entonces en un componente de una arquitectura AIOps controlada, más que en una solución aislada. Su valor depende tanto de la calidad de los datos y de los controles de acceso como del propio modelo.
Dimensionar el modelo y la infraestructura
Se puede considerar un modelo de aproximadamente 24 000 millones de parámetros para tareas de diagnóstico técnico, siempre que se realice una prueba en el entorno de destino. Su rendimiento dependerá de la cuantificación, la longitud del contexto, la calidad de los datos proporcionados y la potencia de cálculo disponible.
El tamaño del modelo es solo uno de los factores a tener en cuenta. Un modelo más compacto, alimentado con información relevante y actualizada, puede resultar más útil que un modelo más voluminoso que reciba un contexto incompleto.
El dimensionamiento de una infraestructura de GPU depende, entre otras cosas:
- Del tamaño y la cuantificación del modelo
- De la longitud del contexto
- Del número de usuarios y de consultas simultáneas
- De la memoria de vídeo disponible
- Del tiempo de respuesta esperado
- De los requisitos de disponibilidad y escalabilidad
El rendimiento debe medirse en casos de uso representativos: tipo de consultas, volumen de datos recuperados, número de usuarios, latencia y calidad de las respuestas. Sin estas mediciones, una configuración de hardware por sí sola no permite predecir la experiencia operativa.
Por lo tanto, la soberanía no se limita a instalar un modelo local. Implica controlar toda la cadena: Recopilación → Transporte → Almacenamiento → Indexación → Análisis → Modelo local → Interfaz DevOps.
AIOps: de la detección a la corrección
El objetivo final de AIOps no es únicamente generar un diagnóstico. Consiste en reducir el tiempo necesario para restablecer el servicio cuando se produce un incidente.
Un ciclo operativo completo puede representarse así: Observar → Detectar → Correlacionar → Diagnosticar → Decidir → Actuar → Verificar.
En un escenario de congestión de red, la plataforma puede detectar un aumento de las retransmisiones, identificar los servicios y los pods afectados y, a continuación, relacionar estas señales con la topología y los eventos recientes. El asistente puede resumir la información disponible, plantear una hipótesis y sugerir las comprobaciones que deben realizarse.
Tras una intervención, los mismos indicadores pueden ayudar a comprobar si la situación mejora. La corrección puede ser manual, semiautomatizada o automatizada, en función del nivel de riesgo y de confianza. Para las acciones que tienen un impacto significativo, suele ser recomendable una validación humana: mover pods, por ejemplo, puede resolver una congestión en un nodo, pero al mismo tiempo crear otra en otro.
Una serie de medidas de seguridad complementan este enfoque: control de los derechos de acceso, registro de las solicitudes y acciones, evaluación periódica de las respuestas, limitación de las acciones automáticas y la posibilidad de recurrir a una decisión humana cuando los datos sean insuficientes o contradictorios.
La IA al servicio de los equipos de operaciones
El valor de la IA generativa en DevOps no reside simplemente en la elaboración de un resumen. Radica en su capacidad para hacer que una investigación resulte más accesible, para poner de relieve las conexiones entre señales dispersas y para orientar los próximos pasos sin ocultar la incertidumbre.
Para lograrlo, el asistente debe basarse en datos verificables, distinguir entre hechos e hipótesis, señalar sus limitaciones y dejar en manos de los equipos el control de las decisiones que entrañan riesgos.
La implementación local complementa este enfoque. Los datos sensibles permanecen dentro del perímetro controlado por la empresa, mientras que los equipos se benefician de una interfaz conversacional capaz de responder rápidamente a sus preguntas. La soberanía se convierte así en un componente de la arquitectura AIOps, y no en una restricción añadida a posteriori.
Con ServicePilot, el objetivo es acercar el análisis de la observabilidad a las necesidades operativas: ayudar a los equipos a comprender lo que está sucediendo, a verificar las posibles causas y a actuar con conocimiento de causa. El objetivo no es simplemente generar texto, sino reducir el tiempo necesario para resolver los incidentes de producción.
