La GenAI souveraine au service des DevOps
GenAI : transformer l’observabilité en diagnostic opérationnel
Les plateformes d’observabilité peuvent collecter des volumes considérables de données. Elles permettent de mesurer la latence, suivre les traces distribuées, collecter les logs, surveiller les pods Kubernetes, analyser les connexions TCP et cartographier les dépendances entre les composants.
Cependant, lors d'un incident, l’ingénieur n’a pas besoin de consulter une multitude de graphiques. Il a besoin d’une réponse claire à une question simple : Pourquoi ce service a-t-il ralenti et que devons-nous faire maintenant ?
Même si la question est simple, il est indispensable de comprendre le contexte :
- Ce qui s’est passé
- Quand cela s’est produit
- Quels utilisateurs ou services sont affectés
- Quelle est la cause la plus probable
- Quelles actions sont prioritaires
- Quel niveau de confiance accorder au diagnostic
L'IA générative peut jouer un rôle déterminant dans cette transformation. En s’appuyant sur les données collectées et sur l’analyse causale, elle peut expliquer un incident en langage naturel, résumer son impact et proposer les prochaines étapes.
Toutefois, les données d’observabilité sont particulièrement sensibles. Elles peuvent révéler la topologie réseau, les noms des applications critiques, les dépendances internes, les volumes de trafic et les caractéristiques de l’infrastructure. Leur transmission vers un service externe peut donc soulever des questions de sécurité, de conformité et de souveraineté. Une IA locale ou Edge permet de répondre à cette problématique. Le modèle de langage, les données d’observabilité et le contexte d’analyse peuvent rester dans l’environnement de l’entreprise, tout en offrant une interface conversationnelle aux équipes techniques.
Un LLM n’est pas un moteur de causalité
Il est important de séparer deux fonctions. Le moteur d’observabilité et d’analyse doit établir les faits :
- Les métriques observées
- Les événements
- Les dépendances
- Les changements
- Les corrélations
- Les hypothèses causales
Le modèle de langage doit ensuite transformer ces résultats en langage clair. Cette distinction limite les risques d’une réponse plausible mais incorrecte. Le LLM ne doit pas inventer une cause à partir d’un simple résumé. Il doit s’appuyer sur les données et les relations produites par le moteur analytique.
Une architecture robuste peut donc suivre le schéma suivant : Télémétrie → Normalisation et enrichissement → Corrélation topologique → Détection d’anomalies → Analyse causale → Contexte structuré → LLM local → Diagnostic en langage naturel.
Le modèle génératif sert alors d’interface de compréhension et d’interaction. Il ne remplace ni les données d’observabilité ni les mécanismes qui les analysent.
Fournir au modèle un contexte vérifiable avec le RAG
Une approche RAG (Retrieval-Augmented Generation) consiste à sélectionner des informations utiles au moment de répondre, au lieu de s’appuyer uniquement sur les connaissances générales du modèle. Le contexte peut comprendre :
- L’incident en cours et les indicateurs associés
- Les ressources et services concernés
- Les relations topologiques pertinentes
- Les changements récents
- Les procédures internes
- Les recommandations approuvées
Le RAG peut aider à ancrer la réponse dans des informations propres à l’environnement. Il ne garantit toutefois pas, à lui seul, l’exactitude du diagnostic. La qualité dépend notamment de la pertinence des données récupérées, de leur fraîcheur et de leur cohérence.
Pour faciliter le contrôle, une réponse devrait distinguer clairement les observations (les données directement constatées), les hypothèses (les explications possibles, accompagnées de leurs éléments d’appui), les informations manquantes (les vérifications nécessaires pour trancher) ainsi que les actions proposées (les prochaines étapes, avec leurs risques éventuels). Cette présentation aide l’opérateur à évaluer la réponse plutôt qu’à la traiter comme une conclusion incontestable.
Déployer localement : maîtriser le périmètre de traitement
Les données d’observabilité peuvent révéler la topologie réseau, les versions des applications critiques, les adresses internes, les dépendances entre services, les informations des clients, etc. Selon les politiques de l’organisation, leur transfert vers un service externe peut soulever des questions de sécurité, de conformité et de maîtrise des données.
Un déploiement sur site ou en périphérie du réseau (Edge) permet de traiter localement le modèle de langage et le contexte utilisé pour répondre. Il peut ainsi réduire la dépendance à un service externe pour chaque requête et maintenir le traitement dans un environnement contrôlé par l’entreprise.
Avec des lois comme le FISA 702 américain, le terme "local" ne suffit cependant pas à décrire tout le périmètre de maîtrise. Il faut aussi examiner la collecte, le transport, le stockage, l’indexation, la gestion des accès, la journalisation, les mises à jour et les dépendances à des composants tiers. La souveraineté dépend donc de l’architecture et de sa gouvernance dans leur ensemble, pas uniquement du lieu d’exécution du modèle.
Au-delà de l'isolement du traitement des données sensibles, une infrastructure GPU locale peut être utilisée pour :
- Servir le modèle de langage
- Accélérer la génération des réponses
- Analyser des volumes importants de contexte
- Conserver une faible latence
- Réduire les coûts récurrents
Intégrer la GenAI locale à la chaîne d’observabilité
Déployer un modèle local ne consiste pas seulement à installer un LLM sur un serveur équipé de GPU. Il faut organiser les échanges entre la plateforme d’observabilité, les composants d’analyse et l’assistant, tout en déterminant quelles données celui-ci peut consulter et quelles opérations il est autorisé à effectuer.
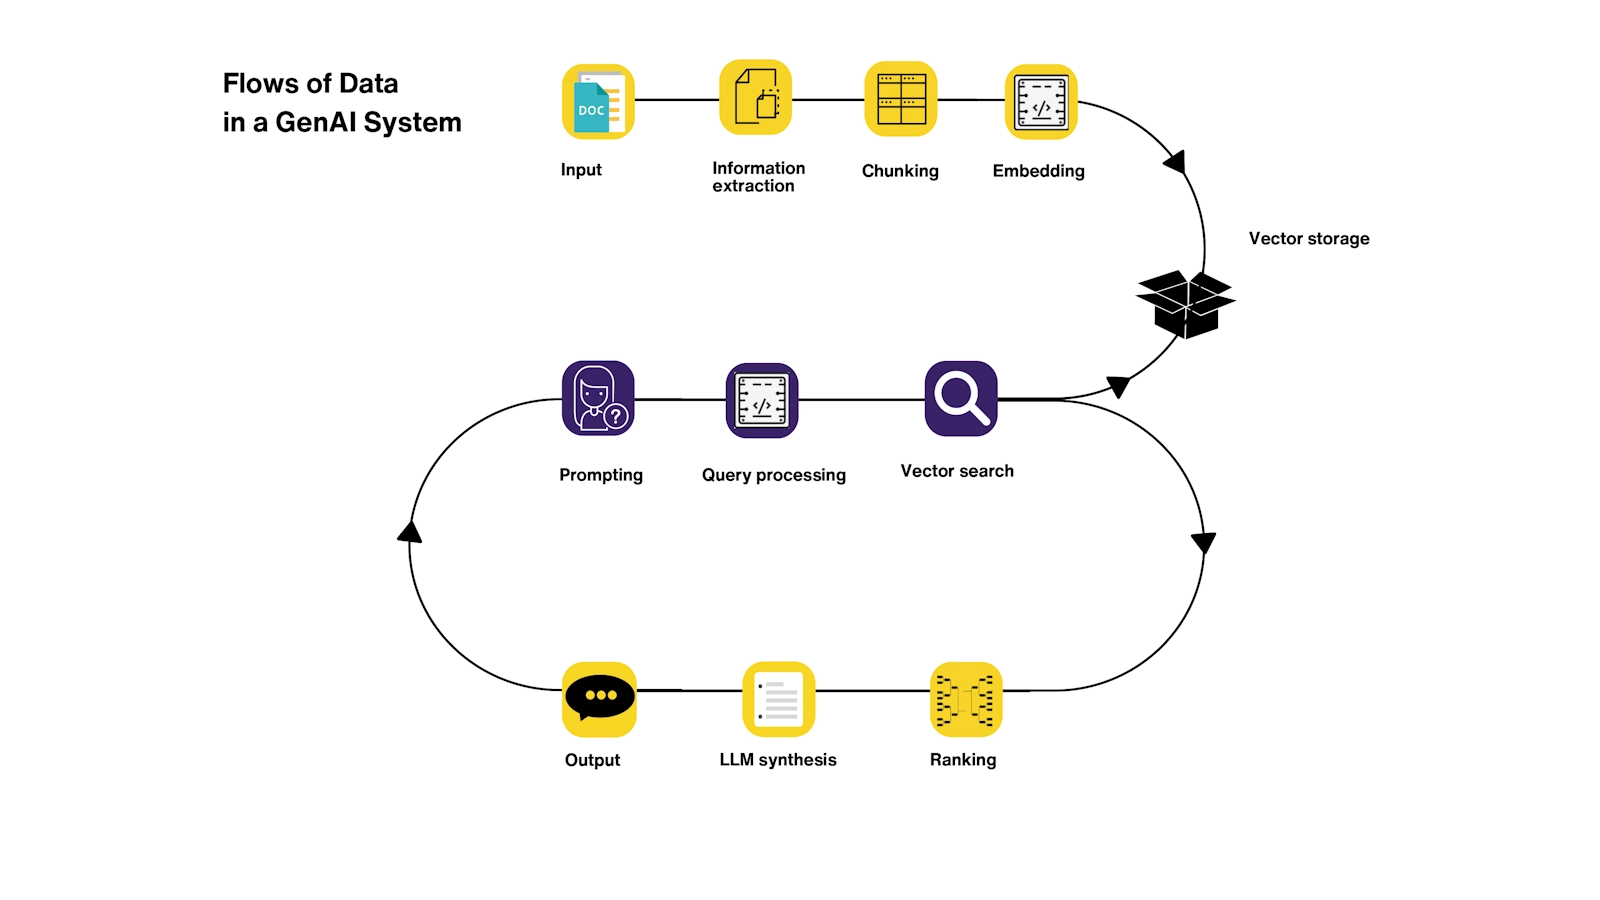
Une architecture peut séparer ces responsabilités en plusieurs composants : la plateforme collecte et normalise la télémétrie, les moteurs de détection et de corrélation identifient les signaux pertinents, une couche de recherche sélectionne les données utiles à la question, enfin, le modèle local formule une réponse à partir de ce contexte. Cette séparation facilite l’évolution de chaque composant et évite de confier au modèle des tâches pour lesquelles il n’est pas conçu, comme établir seul une causalité à partir de données brutes.
Le périmètre de l’assistant doit également être défini. Selon les besoins, il peut consulter les incidents, les métriques, les changements récents ou les procédures internes. Les accès peuvent être limités par rôle, service ou environnement, afin qu’une réponse ne révèle pas des informations auxquelles l’utilisateur n’a pas accès dans les outils d’exploitation habituels. La journalisation et la gestion des identifiants doivent suivre les mêmes exigences que pour les autres composants de la plateforme.
Le choix du déploiement local influe aussi sur l’exploitation. L’équipe doit prévoir la disponibilité du service d’inférence, la gestion des versions du modèle, les mises à jour, la surveillance de la consommation GPU et les mécanismes de repli si l’assistant devient indisponible. Dans un contexte d’incident, l’assistance ne devrait pas devenir un nouveau point de défaillance : les outils habituels de diagnostic doivent rester accessibles.
Enfin, l’intégration peut se faire progressivement. On peut commencer par un assistant en lecture seule, qui synthétise des éléments vérifiables et propose des pistes d’investigation. Une fois sa qualité évaluée sur des incidents représentatifs, il peut être intégré aux procédures d’exploitation, puis éventuellement autorisé à déclencher certaines actions encadrées. Les opérations à fort impact, comme redémarrer un service, déplacer des pods ou modifier une configuration, peuvent rester soumises à une validation humaine.
Le modèle local devient alors une brique d’une architecture AIOps maîtrisée, plutôt qu’une solution isolée. Sa valeur dépend autant de la qualité des données et des contrôles d’accès que du modèle lui-même.
Dimensionner le modèle et l’infrastructure
Un modèle d’environ 24 milliards de paramètres peut être envisagé pour des tâches de diagnostic technique, sous réserve de tests dans l’environnement cible. Ses performances dépendront de la quantification, de la longueur du contexte, de la qualité des données fournies et de la puissance de calcul disponible.
La taille du modèle n’est qu’un facteur parmi d’autres. Un modèle plus compact, alimenté par des informations pertinentes et à jour, peut être plus utile qu’un modèle plus volumineux recevant un contexte incomplet.
Le dimensionnement d’une infrastructure GPU dépend notamment :
- De la taille et de la quantification du modèle
- De la longueur du contexte
- Du nombre d’utilisateurs et de requêtes simultanés
- De la mémoire vidéo disponible
- Du temps de réponse attendu
- Des besoins de disponibilité et de montée en charge
Les performances doivent être mesurées sur des cas d’usage représentatifs : type de questions, volume de données récupérées, nombre d’utilisateurs, latence et qualité des réponses. Sans ces mesures, une configuration matérielle ne permet pas à elle seule de prédire l’expérience opérationnelle.
La souveraineté ne se limite donc pas à installer un modèle local. Elle suppose de maîtriser l’ensemble de la chaîne : Collecte → Transport → Stockage → Indexation → Analyse → Modèle local → Interface DevOps.
AIOps : de la détection à la remédiation
L’objectif final de l’AIOps n’est pas uniquement de produire un diagnostic. Il consiste à réduire le temps nécessaire pour restaurer le service lorsqu'un incident survient.
Une boucle opérationnelle complète peut être représentée ainsi : Observer → Détecter → Corréler → Diagnostiquer → Décider → Agir → Vérifier.
Dans un scénario de contention réseau, la plateforme peut détecter une hausse des retransmissions, repérer les services et les pods concernés, puis mettre ces signaux en relation avec la topologie et les événements récents. L’assistant peut résumer les éléments disponibles, proposer une hypothèse et suggérer les vérifications à effectuer.
Après une intervention, les mêmes indicateurs peuvent aider à vérifier si la situation s’améliore. La remédiation peut être manuelle, semi-automatisée ou automatisée, en fonction du niveau de risque et de confiance. Pour les actions ayant un impact important, une validation humaine est généralement souhaitable : déplacer des pods, par exemple, peut résoudre une contention sur un nœud tout en en créant une sur un autre.
Des garde-fous complètent cette démarche : contrôle des droits d’accès, journalisation des requêtes et des actions, évaluation régulière des réponses, limitation des actions automatiques et possibilité de revenir à une décision humaine lorsque les données sont insuffisantes ou contradictoires.
Une IA au service des équipes d’exploitation
La valeur de l’IA générative en DevOps ne réside pas simplement dans la production d’un résumé. Elle tient à sa capacité à rendre une investigation plus accessible, à mettre en évidence les liens entre des signaux dispersés et à guider les prochaines étapes sans dissimuler l’incertitude.
Pour y parvenir, l’assistant doit s’appuyer sur des données vérifiables, distinguer faits et hypothèses, signaler ses limites et laisser aux équipes le contrôle des décisions à risque.
Le déploiement local complémente cette approche. Les données sensibles restent dans le périmètre contrôlé par l’entreprise, tandis que les équipes bénéficient d’une interface conversationnelle capable de répondre rapidement à leurs questions. La souveraineté devient alors un composant de l’architecture AIOps, et non une contrainte ajoutée après coup.
Avec ServicePilot, l’ambition est de rapprocher l’analyse d’observabilité des besoins opérationnels : aider les équipes à comprendre ce qui se passe, à vérifier les causes possibles et à agir de manière éclairée. L’objectif n’est pas simplement de générer du texte, mais de réduire le temps nécessaire résoudre les incidents de production.
