AIOps: reducir el ruido y identificar la causa raíz de incidentos
¿Qué es AIOps?
El AIOps, o Artificial Intelligence for IT Operations, hace referencia al uso de la inteligencia artificial y el aprendizaje automático para automatizar y mejorar la gestión de las operaciones informáticas.
¿Cómo funciona AIOps?
Las soluciones AIOps se basan en diferentes tecnologías, entre las que destacan el aprendizaje automático (ML), el procesamiento automático del lenguaje natural (NLP) y la inteligencia artificial generativa (GenAI). Analizan de forma continua los datos procedentes de aplicaciones, redes, infraestructuras, incidencias, etc.
Al consolidar esta información, son capaces de destacar los eventos importantes entre una gran cantidad de datos, identificar comportamientos inusuales y detectar deterioros en el rendimiento. También pueden correlacionar varias alertas para identificar el origen real de un incidente, en lugar de tratar cada evento por separado.
En función de su nivel de automatización y del marco de gobernanza establecido, algunas plataformas de AIOps pueden sugerir medidas correctivas o incluso automatizar determinadas acciones previamente validadas. No obstante, las intervenciones directas en los entornos de producción deben limitarse, por lo general, a operaciones controladas, reversibles y sometidas a controles, con el fin de reducir los riesgos de interrupción o de efectos indeseados.
Objetivos y ventajas de AIOps
El objetivo de AIOps coincide con el de la supervisión o la observabilidad: mejorar el rendimiento y la disponibilidad de los sistemas informáticos mediante una supervisión continua para mantener unos servicios más estables, fiables y eficaces.
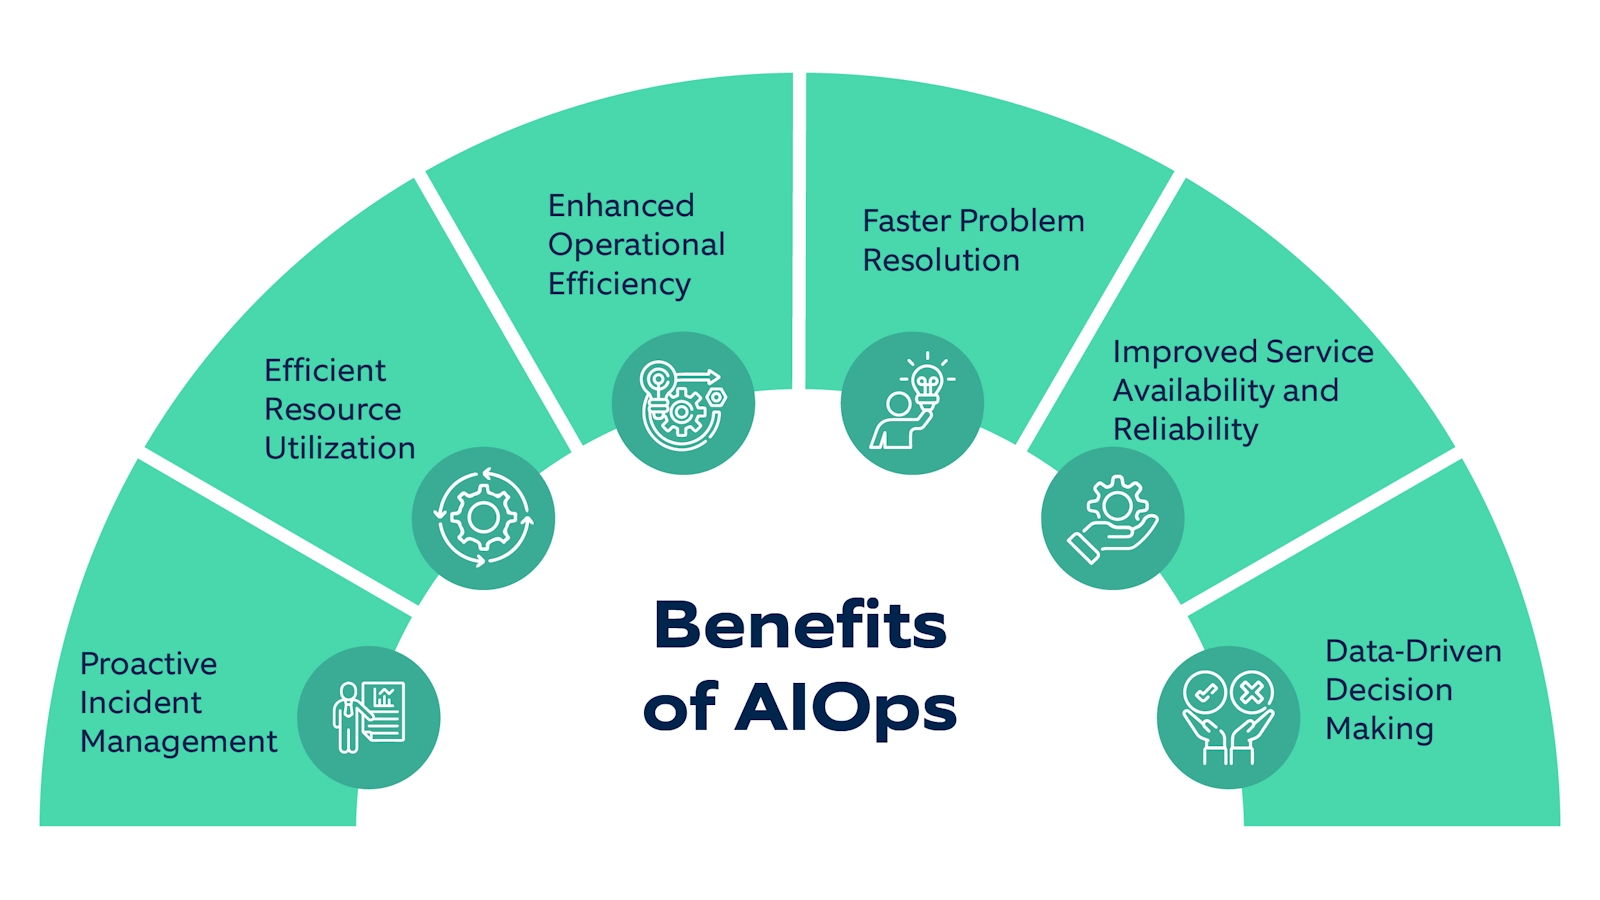
La adopción de AIOps ofrece varias ventajas a los equipos de TI:
- Detectar los problemas de forma proactiva: las anomalías pueden identificarse antes de que provoquen una interrupción o un deterioro perceptible para los usuarios.
- Mejorar la visibilidad: los datos procedentes de diferentes fuentes se agrupan y se ponen en contexto para facilitar el análisis y la toma de decisiones.
- Acelerar la resolución de incidencias: la correlación de eventos y la identificación de las causas principales permiten reducir el tiempo necesario para el diagnóstico.
- Automatizar las operaciones rutinarias: las tareas repetitivas se gestionan automáticamente, lo que reduce los errores humanos y libera tiempo para actividades de mayor valor añadido.
Correlación temporal y correlación estructural
Hay dos tipos de correlación que resultan especialmente importantes para analizar los incidentes en entornos informáticos complejos: la correlación temporal y la correlación estructural. Combinadas en el marco de un enfoque AIOps, permiten sobre todo reducir el ruido, priorizar las señales y determinar una causa probable, en lugar de una simple sucesión de alertas.
La correlación temporal
Busca los eventos que se han producido en una misma ventana temporal. Esta dimensión es esencial para reconstruir la cronología de un incidente. Por ejemplo, un aumento de la latencia observado a las 10:05, seguido unos segundos más tarde por un incremento de los errores de aplicación, puede relacionarse con una saturación de la red detectada a las 10:04. Considerados de forma aislada, cada uno de estos sucesos puede generar una alerta distinta. Analizados en el mismo contexto temporal, pueden corresponder a un único incidente.
La correlación temporal permite así:
- Identificar la primera señal que anuncia un deterioro
- Distinguir la causa inicial de sus consecuencias
- Detectar secuencias recurrentes antes de que se produzca un incidente
- Medir el tiempo transcurrido entre un evento técnico y su impacto en el negocio
- Reducir el número de alertas que los equipos tratan por separado
Este enfoque evita, en particular, considerar cada síntoma como un problema independiente. Un aumento de los errores, una disminución de la tasa de éxito y un incremento de las incidencias de los usuarios pueden ser manifestaciones sucesivas de un mismo fallo.
La correlación estructural / vertical
Se basa en las relaciones entre los componentes. El conocimiento de esta estructura, a menudo denominada topología del servicio o mapa de dependencias, proporciona un contexto indispensable para los eventos recopilados. Una alerta relacionada con un servicio de aplicación no tiene el mismo significado dependiendo de si dicho servicio depende de un componente aislado, de una base de datos saturada o de un equipo de red compartido por varias aplicaciones críticas.
La correlación estructural ayuda, en particular, a:
- Identificar los servicios y componentes que dependen de un recurso con problemas
- Medir el alcance potencial de un incidente
- Evitar tratar como causas a componentes que en realidad son solo víctimas
- Agrupar las alertas procedentes de una misma infraestructura subyacente
- Priorizar los incidentes según los servicios realmente afectados
En un entorno distribuido, esta capacidad es especialmente importante. Un mismo problema de infraestructura puede propagarse a través de varias capas: una interfaz de red con problemas puede afectar a un hipervisor, a varias máquinas virtuales, a nodos de Kubernetes y, posteriormente, a las aplicaciones desplegadas en ellos. Sin una visión topológica, los equipos corren el riesgo de recibir multitud de alertas y de perder tiempo analizando cada componente por separado.
La IA analítica contra la sobrecarga de alertas
De la avalancha de alertas a la identificación del incidente
Los incidentes casi nunca se manifiestan mediante una sola alerta. Cuando cada señal se trata por separado, un único incidente puede convertirse rápidamente en una avalancha de alertas. Los equipos de operaciones pierden entonces tiempo distinguiendo entre los síntomas, las consecuencias y las verdaderas señales precursoras.
Un deterioro de la red puede provocar:
- Un aumento de las retransmisiones TCP
- Un aumento del tiempo de respuesta de un servicio
- Un tiempo de espera agotado por parte del cliente
- Errores en la aplicación
- Reinicios de pods
- Fallos en las pruebas de disponibilidad
- Una disminución del número de transacciones completadas con éxito
- Una escalada de alertas en varias herramientas
Sin correlación, el equipo recibe una sucesión de síntomas que se presentan como tantos incidentes independientes.
A esta situación se la suele denominar «fatiga de alertas». El problema no radica necesariamente en la falta de datos, sino en la incapacidad para interpretarlos de forma conjunta. El reto consiste en agrupar las señales relacionadas, comprender sus relaciones temporales y estructurales y, a continuación, identificar el componente que está provocando el deterioro.
Este es precisamente uno de los objetivos de AIOps. Al combinar la detección de anomalías, la correlación topológica, el análisis histórico y los modelos de causalidad, ServicePilot puede transformar varias decenas de alertas técnicas en un único incidente lógico.
Correlacionar las señales para priorizar los eventos
El volumen de alertas no es un indicador fiable de la gravedad de un incidente. Un único problema puede generar cientos de eventos.
Por lo tanto, AIOps debe realizar varias operaciones:
- Agrupar los eventos cercanos en el tiempo
- Identificar las dependencias entre componentes
- Distinguir los síntomas de las señales precursoras
- Ponderar la criticidad de los eventos
- Detectar comportamientos inusuales
- Comparar la situación actual con los periodos normales
- Reducir las duplicidades
- Generar un único incidente lógico
El objetivo no es eliminar la información, sino jerarquizarla.
La correlación temporal indica que varias señales han evolucionado conjuntamente. La correlación estructural indica que se refieren a componentes relacionados o dependientes entre sí. Es la combinación de ambos enfoques lo que permite distinguir una simple coincidencia de una relación causal plausible.
Por ejemplo, un aumento simultáneo de la latencia en varias aplicaciones constituye un indicio temporal. Si todas estas aplicaciones dependen de un mismo servicio de base de datos, de un mismo nodo o de una misma ruta de red, la correlación estructural refuerza la hipótesis de una causa común. Por el contrario, dos alertas que hayan aparecido al mismo tiempo pero que se refieran a componentes sin relación conocida deberán analizarse de forma independiente.
Esta combinación permite pasar de una lógica reactiva (tratar las alertas a medida que van surgiendo) a una lógica proactiva de análisis de servicios. De este modo, los equipos pueden centrarse en el evento más revelador, evaluar rápidamente su impacto y reducir el tiempo que transcurre entre la detección, el diagnóstico y la resolución del incidente.
La IA predictiva y analítica frente a las averías multicapa
Una alerta no siempre es un diagnóstico. Indica que un comportamiento se desvía de lo esperado, pero no permite necesariamente determinar el origen del problema. Incluso un diagnóstico técnicamente exacto puede resultar difícil de aprovechar si se presenta en forma de cientos de métricas y eventos.
En un sistema distribuido, el primer componente que señala una anomalía suele ser aquel que sufre la consecuencia más visible. Por lo tanto, un pod puede presentar una latencia elevada sin ser responsable de su propio deterioro. La causa puede encontrarse en un nodo, un hipervisor, una interfaz de red o una infraestructura física compartida.
La causa raíz no tiene por qué coincidir con el primer componente que activa una alerta. Un pod de aplicación puede ser el primer elemento visible porque presenta una latencia elevada. Sin embargo, esta latencia puede deberse a un deterioro de un equipo de red situado varios niveles más abajo.
Ejemplo: ralentización de un contenedor de Kubernetes
Imaginemos una aplicación de pagos desplegada en un clúster de Kubernetes. A las 14:00 h, los usuarios comienzan a observar que las transacciones son más lentas. Las métricas de la aplicación indican:
- Un aumento del tiempo de respuesta
- Un aumento de los tiempos de caducidad
- Algunos errores HTTP 504
A nivel de Kubernetes:
- Algunos pods permanecen en estado «Running»
- No se observa ningún fallo masivo
- No se superan los límites de CPU y memoria
- Las réplicas siguen estando disponibles
Un análisis limitado a Kubernetes podría llevar a la conclusión de que el clúster funciona con normalidad. Sin embargo, la observabilidad de pila completa revela progresivamente:
- Los pods afectados se concentran en el pod «worker-03»
- «worker-03» está alojado en una máquina virtual concreta
- Esta máquina virtual comparte una interfaz de red con varias cargas de trabajo
- Aumentan las retransmisiones TCP en las conexiones afectadas
- La cola de red se va llenando
- El equipo o la interfaz física subyacente alcanza su capacidad máxima
- La latencia de red provoca la ralentización de las llamadas de la aplicación
Por lo tanto, el pod no es necesariamente la causa. Es el punto en el que la consecuencia se hace visible.
Modelo de causalidad simplificado: Saturación de la interfaz física → Aumento de la cola de red → Retransmisiones TCP en las conexiones afectadas → Latencia de las llamadas entre servicios → Ralentización del pod de Kubernetes → Errores HTTP y disminución de las transacciones completadas con éxito.
Ejemplo de agrupación
En lugar de mostrar por separado:
Alerta 1: aumento de la latencia TCP en el puerto 443
Alerta 2: retransmisiones TCP en worker-03
Alerta 3: latencia de payment-api
Alerta 4: errores HTTP 504
Alerta 5: fallo en la prueba de disponibilidad
Alerta 6: descenso en la tasa de transacciones completadas con éxito
ServicePilot puede presentar un problema relacionado:
Incidente: deterioro del servicio payment-api en producción
Impacto:
- Aumento del 420 % en la latencia de las transacciones
- Retransmisiones TCP concentradas en worker-03
- Varios pods afectados
- Se han observado errores HTTP 504 en el Ingress
Hipótesis de la causa raíz:
- Saturación de la red en la infraestructura física que aloja worker-03.
Esta presentación cambia radicalmente el trabajo del ingeniero. Ya no necesita revisar manualmente varias alertas procedentes de distintos programas para reconstruir el escenario. El análisis causal de ServicePilot permite remontarse por esta cadena en pocos segundos, cruzando eventos y dependencias en lugar de analizar cada alerta de forma aislada.
El valor añadido de AIOps ServicePilot
Por lo tanto, el valor de una plataforma de supervisión no reside únicamente en su capacidad para recopilar métricas o activar alertas. Reside en su capacidad para transformar esos datos en un contexto útil.
ServicePilot permite relacionar los indicadores de rendimiento, los eventos y las dependencias entre componentes para ofrecer una visión más coherente de la situación. En lugar de presentar una lista de alertas independientes, el objetivo es destacar un escenario de incidente: qué señales aparecieron primero, qué componentes se ven afectados, qué servicios se ven realmente afectados y qué relaciones pueden explicar el deterioro observado.
Este enfoque aporta varias ventajas operativas:
- Menos ruido gracias a la agrupación de las alertas relacionadas
- Un diagnóstico más rápido gracias a una cronología y una topología contextualizadas
- Una mejor priorización en función del impacto en los servicios
- Una reducción de las investigaciones manuales entre varias herramientas de supervisión
- Una comunicación más fluida entre los equipos de infraestructura, red, sistemas y aplicaciones
- Una mejora continua gracias al análisis de incidentes pasados y patrones recurrentes
AIOps refuerza esta correlación aplicando técnicas de análisis automatizadas a los grandes volúmenes de datos generados por los entornos modernos. Los algoritmos pueden relacionar eventos procedentes de diferentes fuentes, detectar comportamientos inusuales, reconocer secuencias ya observadas y estimar la probabilidad de que un conjunto de señales corresponda a un mismo incidente.
El objetivo no es sustituir la experiencia de los equipos, sino hacerla más eficaz. La automatización se encarga del trabajo de conciliación y filtrado, mientras que los equipos conservan la decisión final y el control de las medidas correctivas.
