AIOps : réduire le bruit et identifier la Root Cause des incidents
Qu'est-ce que l'AIOps ?
L’AIOps, ou Artificial Intelligence for IT Operations, désigne l’utilisation de l’intelligence artificielle et du Machine Learning pour automatiser et améliorer la gestion des opérations informatiques.
Comment fonctionne l’AIOps ?
Les solutions AIOps s’appuient sur différentes technologies, notamment le machine learning (ML), le traitement automatique du langage naturel (NLP) et l’intelligence artificielle générative (GenAI). Elles analysent en permanence les données issues des applications, des réseaux, des infrastructures, des incidents, etc.
En consolidant ces informations, elles sont capables de faire émerger les événements importants parmi un grand nombre de données, de repérer les comportements inhabituels et de détecter les dégradations de performance. Elles peuvent également corréler plusieurs alertes afin d’identifier l’origine réelle d’un incident, plutôt que de traiter chaque événement séparément.
Selon leur niveau d’automatisation et le cadre de gouvernance mis en place, certaines plateformes AIOps peuvent suggérer des mesures correctives voire automatiser certaines actions préalablement validées. Néanmoins, les interventions directes sur les environnements de production doivent généralement être limitées aux opérations maîtrisées, réversibles et soumises à des contrôles afin de réduire les risques d’interruption ou d’effets indésirables.
Objectifs et avantages de l'AIOps
L'objectif de l'AIOps rejoint celui de la supervision ou de l'observabilité : renforcer la performance et la disponibilité de l'informatique avec une surveillance continue pour maintenir des services plus stables, fiables et performants.
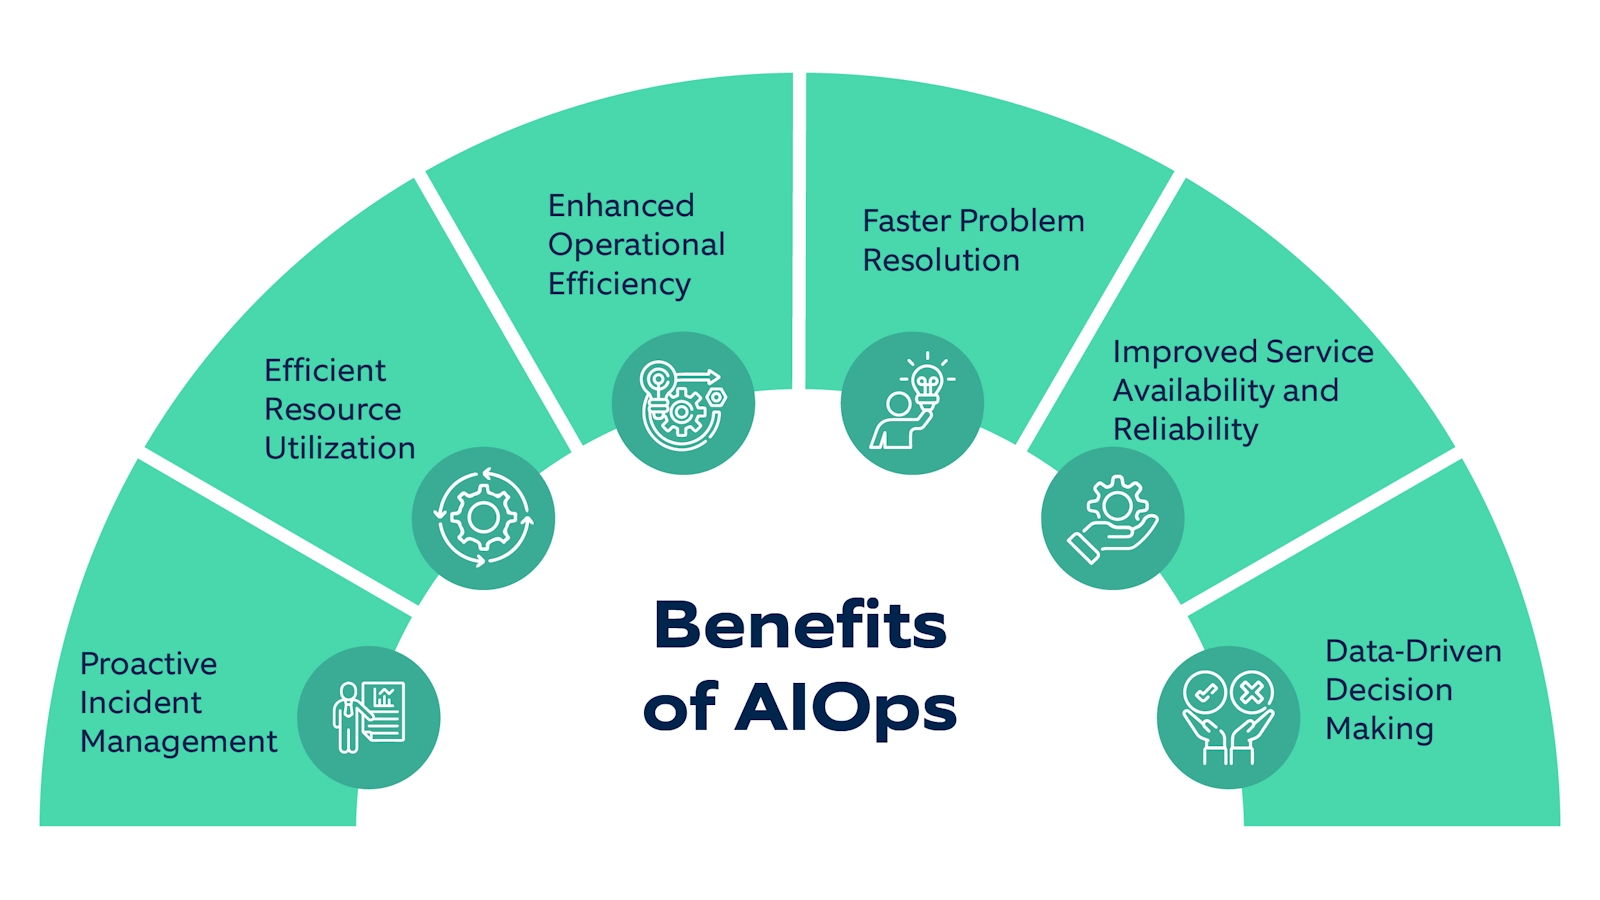
L’adoption de l’AIOps offre plusieurs avantages aux équipes informatiques :
- Détecter les problèmes en amont : les anomalies peuvent être identifiées avant de provoquer une interruption ou une dégradation visible par les utilisateurs.
- Améliorer la visibilité : les données provenant de différentes sources sont regroupées et mises en contexte afin de faciliter l’analyse et la prise de décision.
- Accélérer la résolution des incidents : la corrélation des événements et l’identification des causes principales permettent de réduire le temps nécessaire au diagnostic.
- Automatiser les opérations courantes : les tâches répétitives sont prises en charge automatiquement, ce qui réduit les erreurs humaines et libère du temps pour des activités à plus forte valeur ajoutée.
Corrélation temporelle et corrélation structurelle
Deux formes de corrélation sont particulièrement importantes pour analyser les incidents dans des environnements informatiques complexes : la corrélation temporelle et la corrélation structurelle. Combinées au sein d’une approche AIOps, elles permettent surtout de réduire le bruit, de hiérarchiser les signaux et de faire émerger une cause probable plutôt qu’une simple succession d’alertes.
La corrélation temporelle
Elle recherche les événements apparus dans une même fenêtre temporelle. Cette dimension est essentielle pour reconstituer la chronologie d’un incident. Par exemple, une hausse de la latence observée à 10 h 05, suivie quelques secondes plus tard par une augmentation des erreurs applicatives, peut être mise en relation avec une saturation réseau détectée à 10 h 04. Pris isolément, chacun de ces événements peut générer une alerte distincte. Analysés dans le même contexte temporel, ils peuvent correspondre à un seul et même incident.
La corrélation temporelle permet ainsi de :
- Identifier le premier signal annonciateur d’une dégradation
- Distinguer la cause initiale de ses conséquences
- Repérer les séquences récurrentes avant un incident
- Mesurer le délai entre un événement technique et son impact métier
- Réduire le nombre d’alertes traitées séparément par les équipes
Cette approche évite notamment de considérer chaque symptôme comme un problème indépendant. Une hausse des erreurs, une baisse du taux de succès et une augmentation des tickets utilisateurs peuvent être les manifestations successives d’une même défaillance.
La corrélation structurelle / verticale
Elle s’appuie sur les relations entre les composants. La connaissance de cette structure, souvent appelée topologie de service ou cartographie des dépendances, donne un contexte indispensable aux événements collectés. Une alerte portant sur un service applicatif n’a pas la même signification s'il dépend d’un composant isolé, d’une base de données saturée ou d’un équipement réseau partagé par plusieurs applications critiques.
La corrélation structurelle aide notamment à :
- Identifier les services et composants dépendants d’une ressource dégradée
- Mesurer le rayon d’impact potentiel d’un incident
- Eviter de traiter comme des causes des composants qui ne sont que des victimes
- Regrouper les alertes issues d’une même infrastructure sous-jacente
- Prioriser les incidents selon les services réellement affectés
Dans un environnement distribué, cette capacité est particulièrement importante. Un même problème d’infrastructure peut se propager à travers plusieurs couches : une interface réseau dégradée peut affecter un hyperviseur, plusieurs machines virtuelles, des nœuds Kubernetes, puis les applications qui y sont déployées. Sans vision topologique, les équipes risquent de recevoir une multitude d’alertes et de perdre du temps à analyser chaque composant séparément.
L’IA analytique contre la surabondance d’alertes
De l’avalanche d’alertes à l’identification de l’incident
Les incidents ne se manifestent presque jamais par une seule alerte. Lorsque chaque signal est traité séparément, un incident unique peut rapidement se transformer en une avalanche d’alertes. Les équipes d’exploitation perdent alors du temps à distinguer les symptômes, les conséquences et les véritables signaux précurseurs.
Une dégradation réseau peut entraîner :
- Une augmentation des retransmissions TCP
- Une hausse du temps de réponse d’un service
- Une expiration de délai côté client
- Des erreurs dans l’application
- Des redémarrages de pods
- Des échecs de readiness probe
- Une baisse du nombre de transactions réussies
- Une escalade d’alertes dans plusieurs outils
Sans corrélation, l’équipe reçoit une succession de symptômes présentés comme autant d’incidents indépendants.
Cette situation est souvent appelée "Alert fatigue". Le problème ne vient pas nécessairement d’un manque de données, mais de l’incapacité à les interpréter collectivement. L’enjeu consiste à regrouper les signaux liés, à comprendre leurs relations temporelles et structurelles, puis à identifier le composant à l’origine de la dégradation.
C’est précisément un des objectifs de l’AIOps. En combinant détection d’anomalies, corrélation topologique, analyse historique et modèles de causalité, ServicePilot peut transformer plusieurs dizaines d’alertes techniques en un incident logique unique.
Corréler les signaux pour hiérarchiser les événements
Le volume d’alertes n’est pas un indicateur fiable de la gravité d’un incident. Un problème unique peut générer des centaines d’événements.
L’AIOps doit donc effectuer plusieurs opérations :
- Regrouper les événements proches dans le temps
- Identifier les dépendances entre composants
- Distinguer les symptômes des signaux précurseurs
- Pondérer la criticité des événements
- Détecter les comportements inhabituels
- Comparer la situation actuelle aux périodes normales
- Réduire les doublons
- Produire un incident logique unique
L’objectif n’est pas de supprimer l’information, mais de la hiérarchiser.
La corrélation temporelle indique que plusieurs signaux ont évolué ensemble. La corrélation structurelle indique qu’ils concernent des composants reliés ou dépendants. C’est la combinaison des deux approches qui permet de distinguer une simple coïncidence d’une relation causale plausible.
Par exemple, une hausse simultanée de la latence sur plusieurs applications constitue un indice temporel. Si ces applications dépendent toutes d’un même service de base de données, d’un même nœud ou d’un même chemin réseau, la corrélation structurelle renforce l’hypothèse d’une cause commune. À l’inverse, deux alertes apparues au même moment mais concernant des composants sans relation connue devront être analysées indépendemment.
Cette combinaison permet de passer d’une logique réactive (traiter les alertes au fur et à mesure de leur apparition) à une logique proactive d’analyse de service. Les équipes peuvent alors se concentrer sur l’événement le plus explicatif, évaluer rapidement son impact et réduire le délai entre la détection, le diagnostic et la résolution de l’incident.
L'IA prédictive et analytique face aux pannes multicouches
Une alerte n’est pas toujours un diagnostic. Elle indique qu’un comportement s’écarte d’une situation attendue, mais elle ne permet pas nécessairement de déterminer l’origine du problème. Même un diagnostic techniquement exact peut rester difficile à exploiter s’il est présenté sous la forme de centaines de métriques et d’événements.
Dans un système distribué, le premier composant qui signale une anomalie est souvent celui qui subit la conséquence la plus visible. Un pod peut donc exposer une forte latence sans être responsable de sa propre dégradation. La cause peut se trouver dans un nœud, un hyperviseur, une interface réseau ou une infrastructure physique partagée.
La cause racine ne correspond pas nécessairement au premier composant qui déclenche une alerte. Un pod applicatif peut être le premier élément visible parce qu’il expose une latence élevée. Pourtant, cette latence peut être causée par une dégradation d’un équipement réseau situé plusieurs niveaux plus bas.
Exemple : ralentissement d’un conteneur Kubernetes
Imaginons une application de paiement déployée dans un cluster Kubernetes. À 14 h 00, les utilisateurs commencent à observer des transactions plus lentes. Les métriques applicatives indiquent :
- Une hausse du temps de réponse
- Une augmentation des délais d’expiration
- Quelques erreurs HTTP 504
Au niveau Kubernetes :
- Certains pods restent en état Running
- Aucun crash massif n’est observé
- Les limites CPU et mémoire ne sont pas dépassées
- Les replicas restent disponibles
Une analyse limitée à Kubernetes pourrait conclure que le cluster fonctionne normalement. Pourtant, l’observabilité full-stack révèle progressivement :
- Les pods concernés sont concentrés sur le pod worker-03
- Worker-03 est hébergé sur une machine virtuelle particulière
- Cette machine virtuelle partage une interface réseau avec plusieurs workloads
- Les retransmissions TCP augmentent sur les connexions concernées
- La file d’attente réseau se remplit
- L’équipement ou l’interface physique sous-jacente atteint sa capacité
- La latence réseau provoque le ralentissement des appels applicatifs
Le pod n’est donc pas nécessairement la cause. Il est le point où la conséquence devient visible.
Modèle de causalité simplifié : Saturation de l’interface physique → Augmentation de la file d’attente réseau → Retransmissions TCP sur les connexions concernées → Latence des appels interservices → Ralentissement du pod Kubernetes → Erreurs HTTP et baisse des transactions réussies.
Exemple de regroupement
Au lieu d’afficher séparément :
Alerte 1 : hausse de la latence TCP sur le port 443
Alerte 2 : retransmissions TCP sur worker-03
Alerte 3 : latence de payment-api
Alerte 4 : erreurs HTTP 504
Alerte 5 : readiness probe en échec
Alerte 6 : baisse du taux de transactions réussies
ServicePilot peut présenter un problème corrélé :
Incident : dégradation du service payment-api en production
Impact :
- Augmentation de 420 % de la latence des transactions
- Retransmissions TCP concentrées sur worker-03
- Plusieurs pods affectés
- Erreurs HTTP 504 observées sur l’ingress
Hypothèse de cause racine :
- Saturation réseau sur l’infrastructure physique hébergeant worker-03.
Cette présentation modifie radicalement le travail de l’ingénieur. Celui-ci n’a plus besoin de parcourir manuellement plusieurs alertes provenant de plusieurs logiciels pour reconstituer le scénario. L’analyse causale de ServicePilot permet de remonter cette chaîne en quelques secondes, en croisant les événements et les dépendances plutôt qu’en analysant chaque alerte isolément.
La valeur ajoutée de l'AIOps ServicePilot
La valeur d’une plateforme de supervision ne réside donc pas uniquement dans sa capacité à collecter des métriques ou à déclencher des alertes. Elle réside dans sa capacité à transformer ces données en contexte exploitable.
ServicePilot permet de rapprocher les indicateurs de performance, les événements et les dépendances entre composants afin de proposer une lecture plus cohérente de la situation. Au lieu de présenter une liste d’alertes indépendantes, l’objectif est de faire ressortir un scénario d’incident : quels signaux sont apparus en premier, quels composants sont concernés, quels services sont réellement impactés et quelles relations peuvent expliquer la dégradation observée.
Cette approche apporte plusieurs bénéfices opérationnels :
- Moins de bruit grâce au regroupement des alertes liées
- Un diagnostic plus rapide grâce à une chronologie et une topologie contextualisées
- Une meilleure priorisation en fonction de l’impact sur les services
- Une réduction des investigations manuelles entre plusieurs outils de supervision
- Une communication facilitée entre les équipes infrastructure, réseau, systèmes et applicatives
- Une amélioration continue grâce à l’analyse des incidents passés et des schémas récurrents
L’AIOps renforce cette corrélation en appliquant des techniques d’analyse automatisées aux volumes importants de données générés par les environnements modernes. Les algorithmes peuvent rapprocher des événements provenant de sources différentes, détecter des comportements inhabituels, reconnaître des séquences déjà observées et estimer la probabilité qu’un ensemble de signaux corresponde à un même incident.
Le but n’est pas de remplacer l’expertise des équipes, mais de la rendre plus efficace. L’automatisation prend en charge le travail de rapprochement et de filtrage, tandis que les équipes conservent la décision finale et la maîtrise des actions correctives.
