Observabilité des environnements dynamiques & corrélation verticale
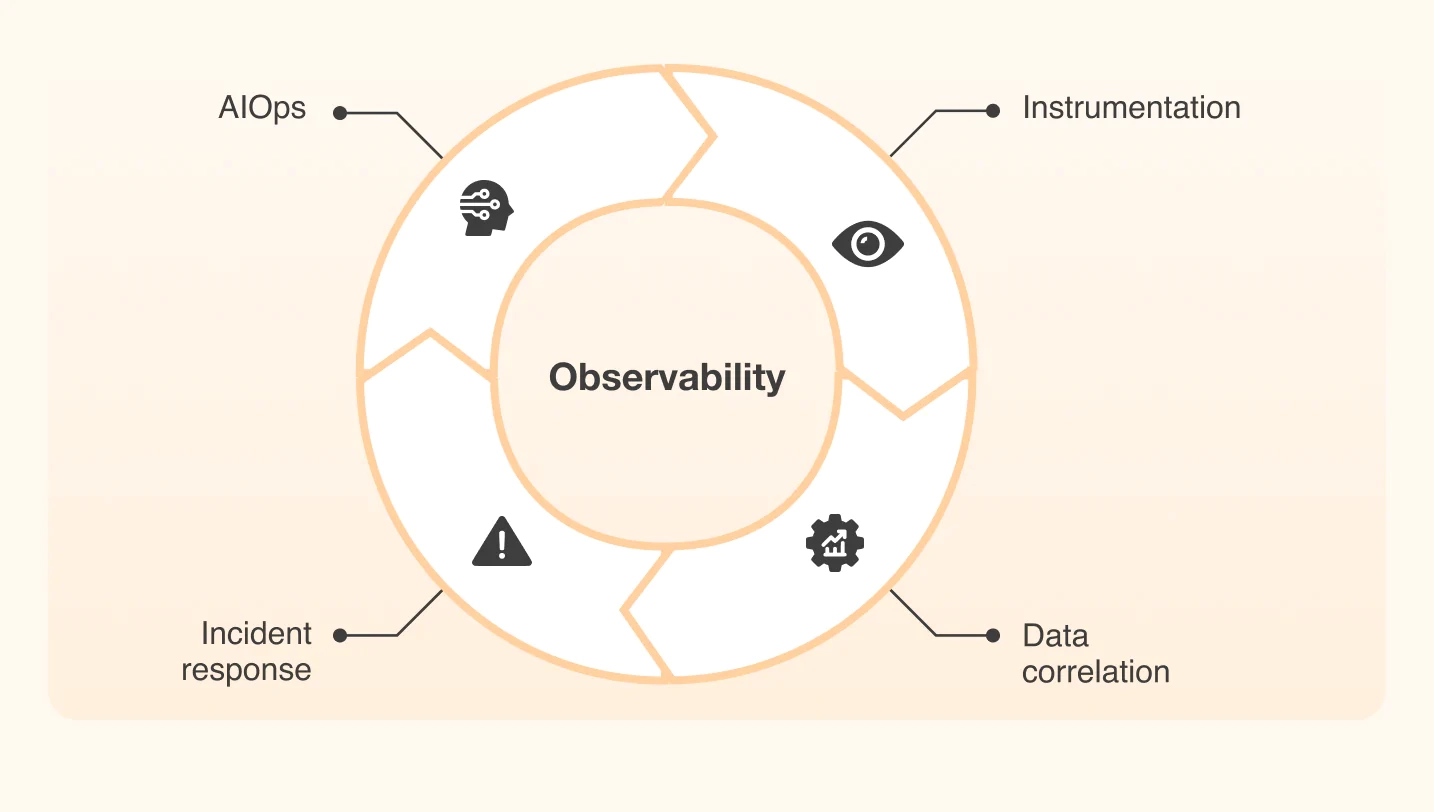
Maîtriser la complexité de K8s grâce à l’observabilité full-stack
Les infrastructures modernes ne ressemblent plus à un ensemble de serveurs clairement identifiés, reliés par quelques équipements réseau et exécutant un nombre limité d’applications.
Elles sont désormais distribuées. Une simple transaction métier peut traverser une application, plusieurs conteneurs, un cluster Kubernetes, une machine virtuelle, un hyperviseur, un serveur physique mutualisé et un ensemble d’équipements réseau avant d’atteindre sa destination. À chaque étape, des métriques, des journaux, des traces et des événements sont générés.
Ces architectures apportent une grande souplesse, mais elles compliquent considérablement le diagnostic. Lorsqu’une application ralentit, l’origine du problème peut se trouver dans le code, le conteneur, le nœud Kubernetes, le stockage ou encore dans une connexion TCP dégradée. Les équipes d’exploitation doivent alors consulter plusieurs outils, comparer des données hétérogènes et tenter de reconstituer manuellement les dépendances entre les composants.
L’observabilité full-stack répond à cette difficulté en offrant une vision unifiée de l’ensemble du système. Grâce à une collecte automatisée, à l’enrichissement des données et à une corrélation dynamique, ServicePilot permet de relier les signaux applicatifs, Kubernetes, réseau et infrastructure.
L’objectif n’est plus seulement de savoir qu’un composant est en anomalie. Il s’agit de comprendre précisément comment cette anomalie affecte le service métier et quelles dépendances peuvent expliquer son apparition.
Dans cet article, nous verrons comment une collecte légère fondée sur des standards ouverts, notamment OpenTelemetry, peut s’intégrer aux environnements Kubernetes et comment la corrélation verticale de ServicePilot permet de relier l'application à l’infrastructure physique qui l’exécute.
☁️ Observabilité des environnements dynamiques et corrélation totale
L’objectif de l’observabilité full-stack est de créer une représentation cohérente du système, depuis l'application jusqu’au réseau physique.
Il ne suffit pas de disposer d’un tableau de bord Kubernetes, d’un logiciel réseau et d’un outil APM séparés. L’enjeu consiste à relier automatiquement les objets observés : une requête, un service, un pod, un nœud, une machine virtuelle, un hyperviseur et le chemin réseau emprunté.
Pourquoi Kubernetes rend l’observabilité plus difficile
Kubernetes apporte une élasticité considérable, mais cette flexibilité augmente mécaniquement la complexité opérationnelle.
Les workloads sont planifiés dynamiquement. Les pods sont créés, déplacés puis supprimés. Les adresses IP peuvent changer. Un service logique peut répartir le trafic entre plusieurs replicas, eux-mêmes répartis sur différents nœuds physiques ou virtuels.
Une requête utilisateur peut ainsi suivre un chemin similaire à celui-ci : Utilisateur → Load balancer → Ingress controller → Service Kubernetes → Pod applicatif → Base de données → Stockage partagé.
À ce chemin applicatif s’ajoutent les couches d’exécution : Application → Conteneur → Pod → Nœud Kubernetes → Machine virtuelle → Hyperviseur → Serveur physique → Réseau et stockage.
Un ralentissement observé au niveau de l’application peut donc avoir une origine située plusieurs couches plus bas. L’équipe d’exploitation doit donc pouvoir répondre à plusieurs questions :
- Le problème vient-il de l'application ou de l’infrastructure ?
- Le pod est-il limité par le CPU, la mémoire ou le réseau ?
- Le nœud Kubernetes est-il lui-même dégradé ?
- Une saturation touche-t-elle le stockage ou l’hyperviseur ?
- Les connexions TCP subissent-elles des retransmissions ?
- Plusieurs alertes correspondent-elles à un seul incident ?
- Quelle est la cause racine et quelle action faut-il entreprendre ?
Une supervision limitée à une seule couche risque alors de confondre symptôme et cause racine.
La collecte native et légère avec OpenTelemetry
OpenTelemetry fournit un cadre standardisé pour collecter des métriques, des logs et des traces à partir des applications et des infrastructures. Il contribue également à réduire la dépendance à des formats propriétaires et facilite l’ajout de métadonnées communes aux différents signaux d’observabilité.
Dans un environnement Kubernetes, cette approche est particulièrement adaptée à la nature éphémère des workloads.
L’instrumentation doit pouvoir suivre automatiquement la création d’un pod, son rattachement à un nœud, son association à un déploiement, le service Kubernetes qui l’expose, les appels sortants vers d’autres composants, les changements de version, les redémarrages et les erreurs ou ralentissements associés.
L’un des intérêts d’une collecte intégrée à l’écosystème Kubernetes est de limiter les opérations manuelles. L’OpenTelemetry Operator, par exemple, peut permettre l’injection automatique d’instrumentation dans les pods au moment de leur déploiement, sans modification directe du code applicatif ni rupture du workflow DevOps.
💡 La corrélation verticale : de la télémétrie à la topologie
La collecte n’est qu’une première étape. La valeur réelle apparaît lorsque les signaux sont rattachés à une topologie. La topologie devient alors un modèle dynamique de dépendances. Elle évolue en fonction des déploiements, des changements de routage et de l’élasticité du cluster. C'est le principe de la corrélation verticale qui consiste à relier plusieurs couches techniques qui sont généralement supervisées séparément.
1. L’infrastructure
La première couche concerne les ressources d’exécution :
- Serveurs physiques
- Processeurs
- Mémoire
- Interfaces réseau
- Disques et baies de stockage
- Machines virtuelles
- Hyperviseurs
- Pools de ressources
- Températures et états matériels
- Files d’attente d’E/S
Une alerte de latence applicative prend une tout autre signification lorsqu’elle peut être associée à une contention CPU sur l’hyperviseur ou à une saturation d’une interface réseau du serveur physique. Dans une informatique multi-sites, un utilisateur d'un site particulier peut ressentir de la latence à cause d'un problème de pare-feu ou de routeur n'ayant aucun lien avec l'infrastructure applicative elle-même.
2. Kubernetes
La couche Kubernetes apporte le contexte d’orchestration :
- Etat des pods
- Redémarrages
- Scheduling
- Disponibilité des replicas
- Limites et requêtes de ressources
- Etat des nœuds
- Evénements du cluster
- Pression CPU, mémoire ou disque
- Services et endpoints
- Ingress
- Volumes persistants
- Règles réseau
L’objectif n’est pas simplement de surveiller Kubernetes en tant que produit. Il s’agit de comprendre l’impact du cluster sur le service métier.
3. La couche 4 : TCP et UDP
Les applications peuvent continuer à répondre tout en subissant une dégradation importante au niveau des connexions.
La couche 4 permet notamment d’observer :
- La latence d’établissement des connexions
- Les retransmissions TCP
- Les pertes de paquets
- Les resets
- Les connexions refusées
- Le nombre de connexions actives
- Les ports saturés
- Les déséquilibres entre clients et serveurs
- Les variations de débit
- Les délais aller-retour
Une retransmission TCP n’est pas nécessairement la cause directe d’un incident applicatif, mais elle constitue un signal important. Lorsqu’elle augmente simultanément avec la durée des requêtes et la saturation d’une interface réseau, elle peut fournir un lien causal particulièrement précieux.
4. Les applications
La couche applicative fournit les signaux les plus proches de l’expérience utilisateur :
- Durée des requêtes
- Taux d’erreur
- Appels interservices
- Traces distribuées
- Exceptions
- Files d’attente internes
- Temps de réponse des bases de données
- Appels vers des API externes
- Débit et volume transactionnel
Une trace distribuée peut montrer qu’une requête a passé 30 millisecondes dans le code métier, mais 800 millisecondes à attendre une connexion réseau. Sans corrélation avec la couche TCP et l’infrastructure, cette différence resterait difficile à interpréter.
🚀 ServicePilot : une observabilité unifiée pour accélérer le diagnostic
OpenTelemetry facilite l’utilisation de métadonnées cohérentes entre les différents signaux, mais la corrélation complète nécessite également un backend comme ServicePilot capable de relier les logs, métriques, traces et événements dans un même logiciel d’analyse.
Pour ServicePilot, cette capacité constitue le socle d’une observabilité réellement full-stack : passer d’un signal isolé à une chaîne de dépendances compréhensible.
Relier les symptômes aux causes possibles
Une alerte de temps de réponse ne fournit pas nécessairement la cause d’un incident. Elle indique seulement qu’une dégradation est observée au niveau du service. Pour comprendre son origine, il faut pouvoir la mettre en relation avec les autres signaux apparus au même moment.
Avec ServicePilot, une augmentation de la durée des requêtes peut être examinée conjointement avec :
- Un changement récent de déploiement
- Une hausse des retransmissions TCP
- Une saturation CPU d’un nœud
- Une limitation réseau du conteneur
- Une pression mémoire ou disque
- Une dégradation d’un volume persistant
- Une surcharge d’un hyperviseur ou d’un serveur physique partagé
- Une augmentation du taux d’erreur d’un service distant
- Des retransmissions TCP
- Une perte de paquets sur une interface
- Un problème sur un équipement réseau d'un site en particulier
- Une dégradation du stockage sous-jacent
La corrélation de ces informations aide les équipes à distinguer le symptôme de la cause probable. Elle réduit les investigations fondées uniquement sur des hypothèses et facilite la priorisation des actions correctives.
Réduire le temps de résolution des incidents
La valeur d’une observabilité full-stack se mesure principalement dans les situations où le temps compte. Lorsqu’un service critique ralentit, les équipes doivent rapidement déterminer l’étendue de l’incident, identifier les composants concernés et évaluer son impact métier.
En regroupant les informations utiles dans un même contexte d’analyse, ServicePilot contribue à réduire les allers-retours entre outils et à accélérer les phases de diagnostic. Les équipes disposent d’une vision plus claire des dépendances entre les services et peuvent concentrer leurs efforts sur les composants les plus susceptibles d’être à l’origine de la dégradation.
Cette approche présente également un intérêt en dehors des incidents. Elle peut être utilisée pour :
- Valider l’impact d’un nouveau déploiement
- Identifier les services les plus dépendants d’une infrastructure donnée
- Anticiper les risques de saturation
- Comparer les performances entre plusieurs versions
- Analyser les tendances de consommation
- Documenter la topologie réelle d’un environnement
- Vérifier les effets d’une modification réseau ou infrastructure
ServicePilot, de la visibilité à l'action
Dans un environnement Kubernetes, la visibilité ne peut plus être limitée à l’état des pods ou à l’utilisation des ressources. Les performances d’une application dépendent d’un ensemble de couches interconnectées : code, conteneurs, nœuds, machines virtuelles, hyperviseurs, réseau et infrastructure physique. Une observabilité efficace doit donc être capable de suivre les composants malgré leur caractère dynamique et de conserver le contexte nécessaire à leur analyse. La collecte automatisée, l’enrichissement par les métadonnées Kubernetes et la corrélation des métriques, logs, traces et événements constituent les fondations de cette approche.
L’observabilité ne doit pas uniquement produire davantage de données. Elle doit rendre ces données compréhensibles et directement exploitables par les équipes qui assurent la disponibilité des services. En associant collecte, enrichissement, topologie et corrélation, ServicePilot fournit une représentation commune aux équipes applicatives, DevOps, réseau et infrastructure. Chacune peut conserver son niveau d’analyse tout en partageant un même contexte technique.
C’est cette capacité à relier les différentes couches qui permet à ServicePilot de transformer une supervision fragmentée en une observabilité réellement full-stack : une observabilité conçue non seulement pour détecter les anomalies, mais aussi pour comprendre rapidement leur impact et orienter les équipes vers les actions appropriées.
Avec ServicePilot, l’observabilité full-stack devient un outil de compréhension opérationnelle : elle permet de relier l’expérience utilisateur aux composants techniques, afin de diagnostiquer plus rapidement les incidents et de mieux maîtriser la complexité des environnements IT modernes.
